VPC CNI vs Cilium CNI 성능 비교 벤치마크
개요
이 문서는 VPC CNI와 Cilium의 역할을 비교하고, 2026년 2월 9일자로 저장된 다섯 가지 구성의 성능 요약을 검토합니다. 요약 JSON과 실행 스크립트는 남아 있지만 원본 iperf3·Fortio 로그, 반복 실행별 결과, 당시 적용된 Helm 설정은 없습니다. 따라서 수치는 기존 기록의 관측값으로 읽어야 하며, 재현이 확인된 제품 순위로 사용할 수 없습니다.
2026년 9월 검토에서 평균 RTT를 백분위수로 표시한 부분, D의 HTTP p99를 E의 값으로 인용한 부분, 스크립트와 다른 측정 조건을 바로잡았습니다. 특정 옵션의 개선율과 원본 자료가 없는 서비스 확장 그래프는 제거했습니다. 이번 검토에서는 클러스터나 벤치마크를 실행하지 않았습니다.
CNI 선택에는 IP 할당과 라우팅뿐 아니라 서비스 부하 분산, 정책, 관측 기능의 요구사항도 함께 봐야 합니다. 이 기능들을 같은 조건으로 구성한 뒤 실제 애플리케이션에서 측정해야 의미 있는 비교가 됩니다.
테스트 환경
저장소의 cluster.yaml과 run-all-scenarios.sh가 선언하는 환경입니다. 선언된 값이 당시 실행 환경과 일치하는지는 별도로 확인해야 합니다.
| 항목 | 기록된 설정 | 해석 시 주의점 |
|---|---|---|
| 클러스터 | EKS 1.31, ap-northeast-2, cni-bench | 과거 실험 설정이며 현재 권장 버전이 아님 |
| 노드 | m6i.xlarge 3대, 노드 그룹은 같은 가용 영역 | 4 vCPU·16 GiB, 네트워크는 최대 12.5 Gbps 사양이며 지속 기준 대역폭이라는 뜻이 아님 |
| Cilium | Helm 차트 1.16.5 | 적용된 전체 values와 이미지 digest는 보존되지 않음 |
| 워크로드 | bench 네임스페이스, iperf3·Fortio·httpbin | 일부 이미지가 latest이고 클라이언트·서버의 노드 분리를 보장하는 제약이 없음 |
실험을 다시 설계할 때는 커널·ENA 드라이버·AMI·MTU·CNI 및 kube-proxy 버전, Pod와 노드 배치, 부하 발생기 CPU 사용량을 함께 기록해야 합니다.
테스트 시나리오
다음은 스크립트가 의도한 설정입니다. 실제로 활성화된 데이터 경로를 증명하는 상태 출력은 남아 있지 않습니다.
| 시나리오 | IP 할당·라우팅 | 서비스 처리 | 추가 설정 |
|---|---|---|---|
| A | VPC CNI | kube-proxy | 초기 구성 |
| B | Cilium cluster-pool, VXLAN | kube-proxy 유지 | Hubble 비활성화 |
| C | Cilium cluster-pool, VXLAN | Cilium kube-proxy replacement | Hubble 비활성화 |
| D | Cilium ENI IPAM, native routing | Cilium kube-proxy replacement | prefix delegation 요청, Hubble 비활성화 |
| E | D와 같은 IPAM·라우팅 계열 | Cilium kube-proxy replacement | host routing, BPF masquerade, conntrack 크기, socket LB, Bandwidth Manager·BBR, DSR·native XDP 설정 |
시나리오 E 튜닝 포인트
E의 스크립트는 loadBalancer.mode=dsr와 loadBalancer.acceleration=native를 설정합니다. 기존 설명의 “DSR·XDP 제외”와 일치하지 않습니다. 설정을 요청한 것과 해당 노드·드라이버에서 실제 적용된 것은 구분해야 합니다.
Hubble은 B부터 이미 비활성화되어 있어 D→E의 새로운 변화가 아닙니다. B·C에는 Bandwidth Manager를 켜는 옵션도 없습니다. 여러 옵션을 동시에 바꾼 기록에서 RTT나 UDP 손실률 차이를 어느 한 옵션의 효과로 배분할 수 없습니다.
아키텍처
패킷 경로 비교: VPC CNI vs Cilium
VPC CNI의 IP 할당과 kube-proxy의 Service 전달은 서로 다른 역할입니다. Cilium 역시 IPAM·라우팅과 kube-proxy replacement를 구분해서 설정합니다. Pod IP로 직접 보낸 트래픽, ClusterIP 트래픽, 외부에서 NodePort로 들어오는 트래픽은 경로가 다르므로 하나의 “CNI 지연”으로 묶지 않습니다.
Cilium 아키텍처 개요
Cilium agent는 노드에서 네트워크와 정책을 구성하고, operator는 선택한 모드에 따라 IPAM 같은 클러스터 범위 작업을 수행합니다. 아래 그림은 구성 요소를 이해하기 위한 기존 개념도이며 이 실험에서 각 기능이 활성화되었다는 증거는 아닙니다.
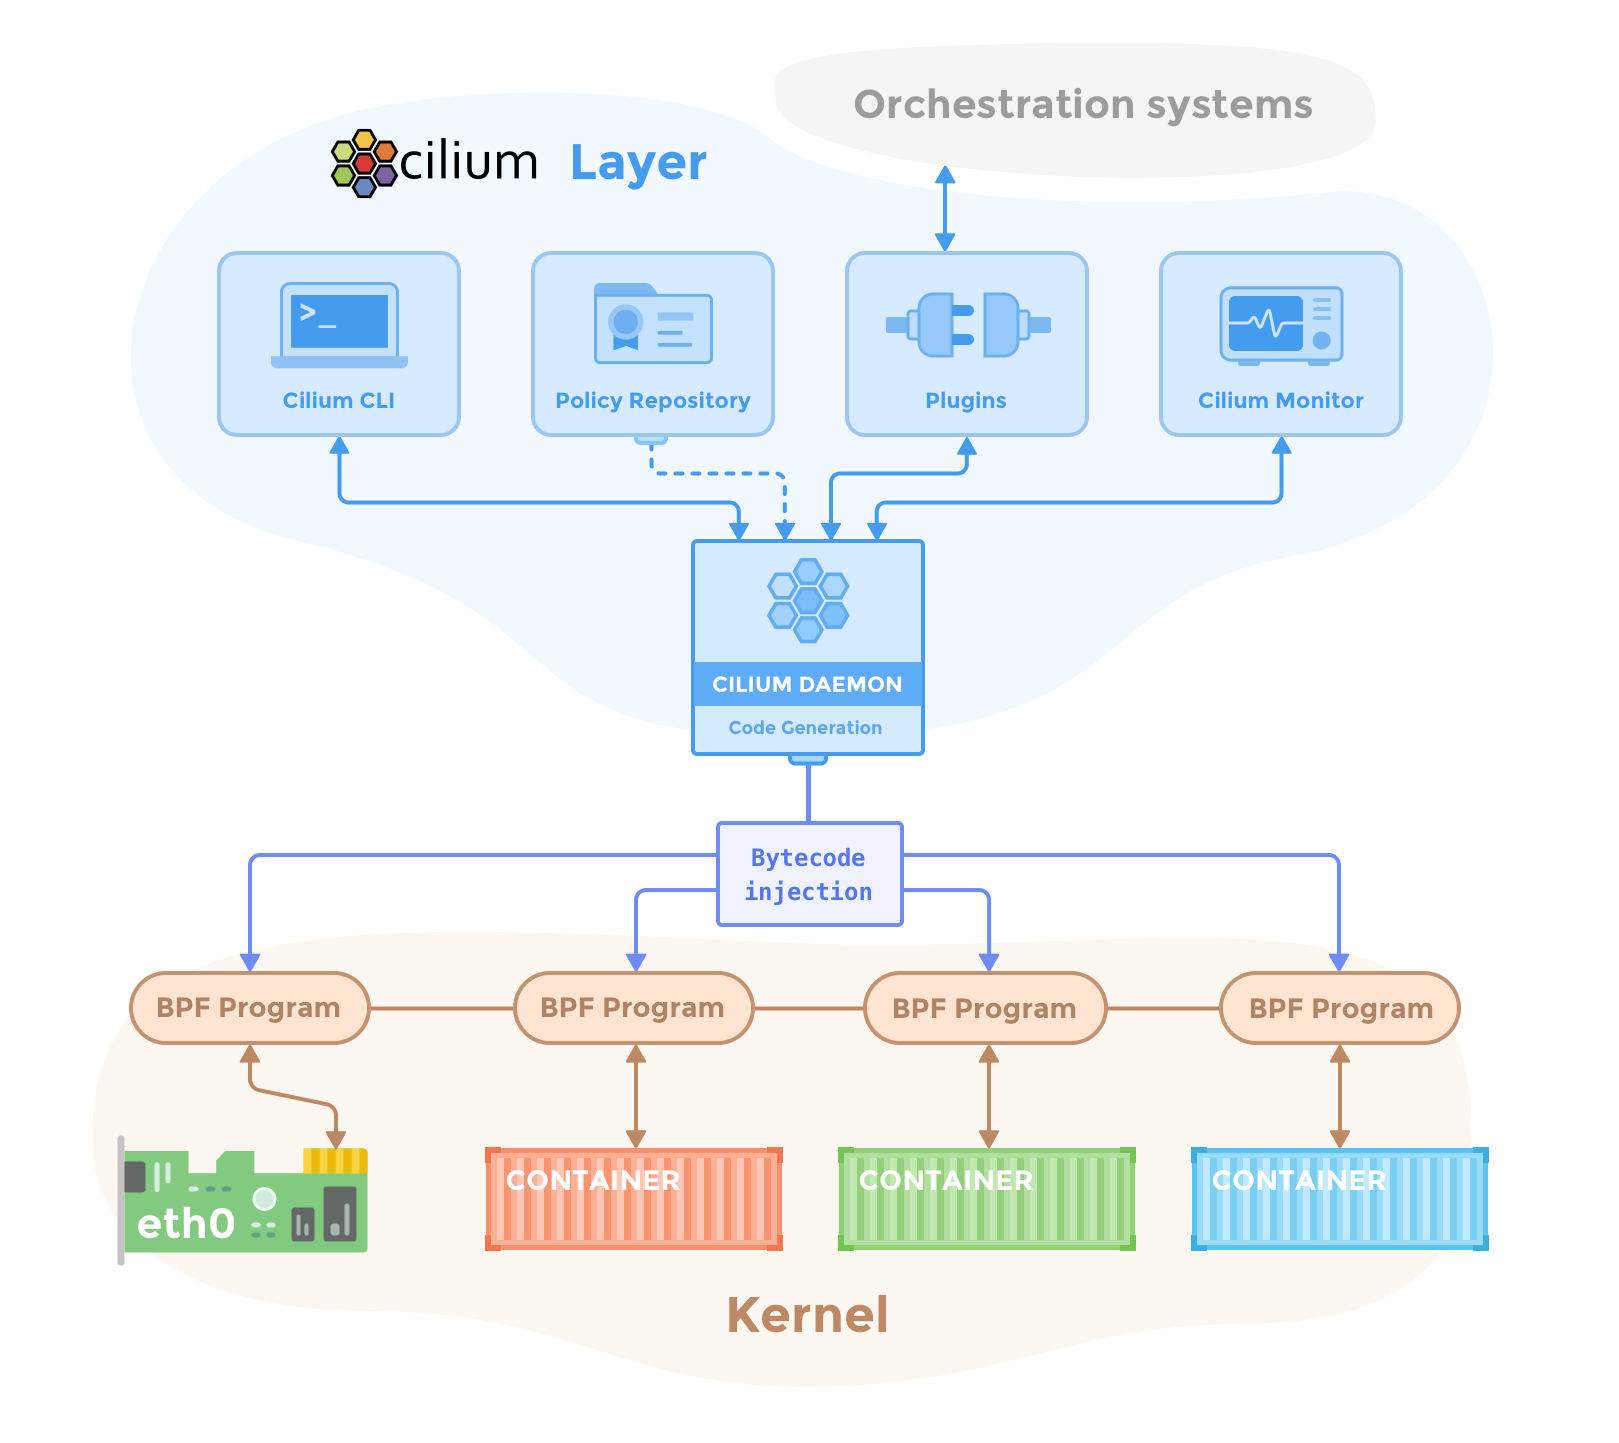
Cilium eBPF 패킷 경로
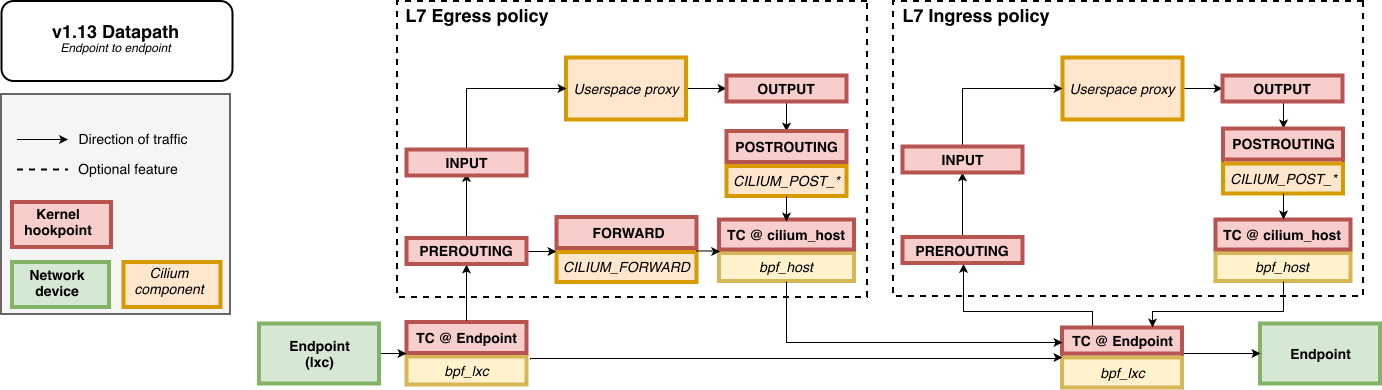
eBPF 프로그램은 선택된 hook에서 전달·정책 처리를 수행합니다. socket LB, host routing, 터널, L7 프록시 사용 여부에 따라 실제 경로가 달라집니다. 아래 자료는 Cilium 1.13 계열의 역사적 경로도입니다. 1.16.5 실험이나 현재 릴리스의 정확한 호출 순서로 사용하지 않습니다.
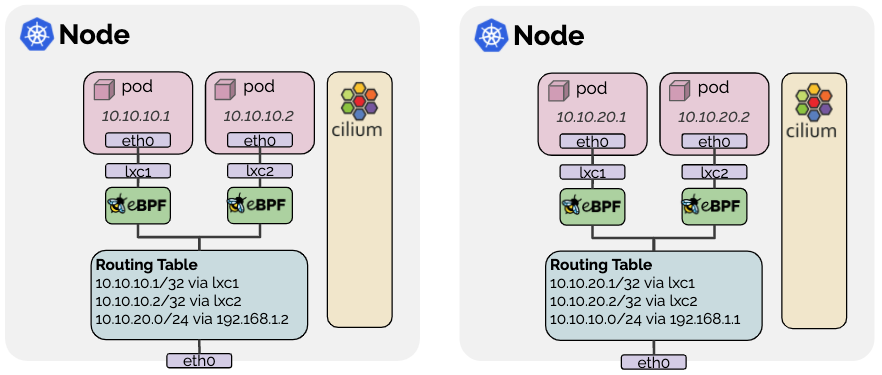
Cilium Native Routing (ENI 모드)
Native routing은 Pod 트래픽을 터널로 감싸지 않고 하부 네트워크가 라우팅하도록 구성하는 방식입니다. ENI IPAM은 AWS ENI에서 Pod IP를 확보하는 방식으로, 두 개념이 같은 것은 아닙니다. VPC 경로, 보안 그룹, 반환 경로와 MTU가 함께 맞아야 통신할 수 있습니다.
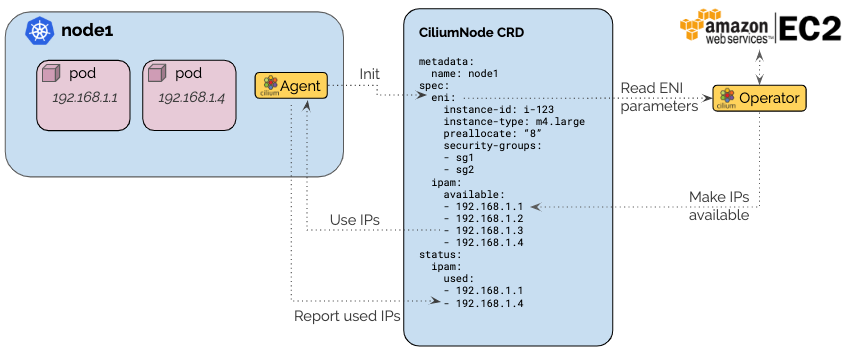
Cilium ENI IPAM 아키텍처
ENI IPAM은 AWS API 권한과 서브넷의 주소 여유, 인스턴스별 ENI·IP 한도에 영향을 받습니다. 차트 옵션만 설정하면 권한과 네트워크가 자동으로 준비된다고 가정해서는 안 됩니다.
5개 시나리오별 데이터 플레인 스택
A→B는 CNI와 캡슐화 방식, B→C는 Service 처리, C→D는 IPAM·라우팅, D→E는 여러 데이터 경로 옵션을 바꾸려는 구성입니다. 이 순서로 실행했다고 해서 각 단계의 차이가 한 가지 원인으로 설명되지는 않습니다. 새 실험에서는 같은 노드 배치를 유지하고 설정 하나씩 바꾸는 비교를 추가해야 합니다.
테스트 방법
테스트 워크로드
workloads.yaml은 iperf3 송수신 Pod와 HTTP 부하 발생기·서버를 배포합니다. CPU 요청량, 서버 복제 수, Service endpoint 배치가 네트워크 결과에 영향을 줄 수 있습니다. 재실험 시 같은 노드·다른 노드·다른 가용 영역을 별도 항목으로 나누고 실제 Pod IP와 nodeName을 보존합니다.
측정 메트릭
| 항목 | run-benchmark.sh의 동작 | 해석 범위 |
|---|---|---|
| TCP 처리량 | 30초, 병렬 스트림 8개; 수신 측 end.sum_received.bits_per_second 추출 | 이 연결·배치에서의 수신 처리량 |
| UDP 처리량·손실 | 30초, -u -b 10G; end.sum 필드 추출 | 10 Gbit/s 목표 부하이며 무제한 부하가 아님; 송수신 원본 통계를 함께 보존해야 함 |
| TCP 평균 RTT | 10초, --length 1; 첫 sender의 mean_rtt 추출 | TCP 송신 측 평균이며 TCP_RR 요청·응답 실험이나 p50·p99가 아님 |
| HTTP | 30초씩 목표 1,000 QPS/32연결, 5,000 QPS/64연결, 제한 없는 QPS/64연결 | 목표 부하와 달성 부하를 구분하고 오류·응답 내용을 따로 검증해야 함 |
| DNS | getent hosts 200회에 대한 셸 시간 측정 | 순수 DNS 서버 지연이 아니라 프로세스 실행·이름 해석 비용 포함 |
벤치마크 실행
기존 스크립트와 요약 데이터는 과거 실험 자료입니다. run-all-scenarios.sh는 클러스터를 만들고 aws-node와 kube-proxy를 삭제하면서 네트워크 구성을 바꿉니다. 검증된 재현 절차나 기존 클러스터의 CNI 전환 가이드로 사용하지 않습니다.
재실험 전에는 전용 계정·클러스터·리전과 비용 범위를 정하고, 각 구성의 지원 조건·IAM·복구 방법을 확인해야 합니다. 원본 로그, 종료 코드, 응답 검증, 적용된 values, 이미지 digest를 실행별 디렉터리에 남기고 실패한 실행을 성공값에 섞지 않습니다. 현재 스크립트는 같은 요약 파일을 덮어쓰며 반복 분포를 보존하지 않습니다. 정리 함수가 실제로 호출되는지도 점검해야 합니다.
벤치마크 결과
아래 수치는 저장된 JSON과 일치하도록 정리했습니다. 이것으로 당시 실행의 성공 여부, 표본 수, 측정 오차까지 확인되는 것은 아닙니다. 원본 로그가 확보되기 전에는 “3회 이상 중앙값”이나 “5% 오차 범위”라는 설명을 붙이지 않습니다.
네트워크 성능
TCP/UDP 처리량
TCP 처리량
0–14 Gbps
저장된 값은 12.34–12.41 Gbps입니다. 이 좁은 범위만으로 다른 트래픽에서도 구성이 동등하다고 결론 내릴 수 없습니다.
UDP 처리량
0–14 Gbps
A와 D의 손실률은 각각 20.39%, 20.42%입니다. 송신·수신 원본 로그 없이 처리량 필드에서 손실을 다시 차감하거나 무손실 처리량으로 해석하지 않습니다.
| 시나리오 | TCP (Gbps) | UDP (Gbps) | UDP 손실률 (%) |
|---|---|---|---|
| A: VPC CNI | 12.41 | 10.00 | 20.39 |
| B: Cilium + kube-proxy | 12.34 | 7.92 | 0.94 |
| C: Cilium, no kube-proxy | 12.34 | 7.92 | 0.69 |
| D: Cilium ENI | 12.41 | 10.00 | 20.42 |
| E: Cilium ENI, additional options | 12.40 | 7.96 | 0.03 |
m6i.xlarge의 최대 네트워크 사양과 가까운 TCP 값이 기록되어 있습니다. 그렇다고 모든 연결 수·패킷 크기·지속 시간에서 같은 성능을 보장하거나 CNI 간 차이가 없다는 뜻은 아닙니다. 부하 발생기와 수신 측 통계부터 확인해야 합니다.
Pod-to-Pod 지연
평균 RTT
0–6000 µs
E의 기록이 가장 작지만 여러 설정이 동시에 바뀌었습니다. 특정 옵션의 효과나 재현 가능한 개선율은 이 기록만으로 입증되지 않습니다.
| 시나리오 | 평균 RTT (µs) |
|---|---|
| A: VPC CNI | 4894 |
| B: Cilium + kube-proxy | 4955 |
| C: Cilium, no kube-proxy | 5092 |
| D: Cilium ENI | 4453 |
| E: Cilium ENI, additional options | 3135 |
평균 TCP RTT와 HTTP p99는 측정 대상이 다릅니다. 이 RTT를 에이전트의 도구 호출 횟수에 곱해 전체 응답 지연이나 사용자 경험 개선율을 계산하지 않습니다.
UDP 패킷 손실률
| 시나리오 | 저장된 손실률 |
|---|---|
| A | 20.39% |
| B | 0.94% |
| C | 0.69% |
| D | 20.42% |
| E | 0.03% |
손실률 차이는 확인되지만 원인은 확인되지 않았습니다. 송신 속도, 수신 CPU, 패킷 크기, pacing, 큐와 드라이버 상태를 함께 비교해야 합니다. Cilium Bandwidth Manager의 지원 기능과 이 실험에서 관측된 손실률은 별개의 근거입니다. BBR은 TCP 혼잡 제어이므로 UDP 결과를 BBR의 직접적인 효과로 설명하지 않습니다.
HTTP 애플리케이션 성능
p99 @ 1,000 QPS
0–12 ms
D는 8.75 ms, E는 9.89 ms입니다. 기존 본문이 E에 인용한 8.75 ms를 바로잡았습니다.
속도 제한 없는 실행의 처리량
0–5000 QPS
0부터 시작하는 동일 눈금을 사용합니다. 이 한 번의 부하 설정으로 시스템의 최대 지속 처리량을 정할 수 없습니다.
| 시나리오 | p99 @ 1,000 QPS (ms) | 속도 제한 없는 실행 (QPS) |
|---|---|---|
| A: VPC CNI | 10.92 | 4103.9 |
| B: Cilium + kube-proxy | 9.87 | 4044.7 |
| C: Cilium, no kube-proxy | 8.91 | 4019.3 |
| D: Cilium ENI | 8.75 | 4026.4 |
| E: Cilium ENI, additional options | 9.89 | 4181.9 |
목표 5,000 QPS 실행의 저장값은 다음과 같습니다. 목표에 못 미치는 처리량을 5,000 QPS가 처리되었다고 표현하지 않습니다.
| 시나리오 | 달성 QPS | p99 (ms) |
|---|---|---|
| A | 4,071.1 | 440.45 |
| B | 4,012.0 | 21.60 |
| C | 3,986.5 | 358.38 |
| D | 3,992.6 | 23.01 |
| E | 4,053.2 | 24.44 |
1,000 QPS 실행의 A→E p99 차이는 기록상 약 9.4%이고, A→D는 약 19.9%입니다. 반복 자료 없이 이 차이를 유의미한 개선으로 단정할 수 없습니다. 높은 부하에서 p99가 크게 달라지는 이유도 원본 응답·오류·CPU 자료로 확인해야 합니다.
서비스 수 확장에 따른 성능 영향 (Scenario E)
기존 서비스 수 확장 그래프에는 여기서 인용할 수 있는 실행별 원본 자료가 없습니다. 몇 개의 서비스 수에서 얻은 값만으로 지연이 일정하거나 알고리즘이 O(1)이라고 입증할 수 없습니다. 서비스 수 외에 endpoint 수, 대상 Service의 위치, 연결 생성률, 규칙 변경률을 통제한 재측정이 필요합니다.
kube-proxy (iptables) 서비스 스케일링: 4 → 104 → 1,000개
4·104·1,000개는 과거 설명에서 사용한 실험 지점이며 현재 검증된 결과가 아닙니다. iptables 모드의 규칙 탐색 비용과 실제 HTTP 지연을 구분해야 합니다. kube-proxy의 Service 규칙은 목적지 Service를 찾고, endpoint 선택은 별도 규칙으로 이루어집니다. 모든 SYN이 전체 규칙을 평균 절반씩 검사한다고 단정하지 않습니다.
keepalive vs Connection:close 비교 분석
연결 재사용은 새 연결을 만들 때의 비용을 줄일 수 있습니다. conntrack은 패킷 내용을 캐시하는 것이 아니라 연결과 NAT 상태를 추적합니다. 새 연결·기존 연결, TCP handshake·애플리케이션 요청을 나누어 측정해야 kube-proxy와 연결 재사용의 영향을 구분할 수 있습니다.
DNS 해석 성능 및 리소스 사용량
요약의 DNS p50/p99(ms)는 A 2/4, B 2/4, C 2/2, D 2/4, E 2/3입니다. getent와 셸 시간 측정의 결과이므로 “CoreDNS 처리 지연”으로 바꾸어 부르지 않습니다. 조회 성공 여부, 캐시 상태, 정밀한 시간 측정 자료가 필요합니다. 스크립트의 kubectl top 출력은 요약 JSON에 저장되지 않아 기존 CPU·메모리 비교 수치는 이 보고서에서 제외했습니다.
튜닝 포인트별 영향도
E는 여러 옵션을 동시에 바꾸므로 개별 기여도를 구할 수 없습니다. Bandwidth Manager를 평가한다면 적용된 Pod 대역폭 annotation과 실효 설정을 기록하고, BBR은 TCP 부하로 별도 측정합니다. conntrack map 크기 변경도 실제 엔트리 수·압박·드롭과 메모리를 관측한 뒤 평가해야 합니다.
핵심 결론: 성능 차이 vs 기능 차이
현재 자료가 보여주는 것은 다섯 구성의 저장된 요약값과 재검증해야 할 차이입니다. UDP 손실 차이만으로 제품의 전반적인 성능을 순위화하거나, 비슷한 TCP 처리량을 근거로 모든 워크로드가 동등하다고 결론 내릴 수 없습니다.
정책 표현력이나 서비스 처리 방식은 공식 기능 문서로 비교하고, 처리량·지연·운영 비용은 같은 요구사항을 충족하는 구성에서 측정합니다. “eBPF이므로 더 빠르다”는 설명 대신 어떤 패킷 경로와 작업을 줄였는지, 그 효과가 애플리케이션에서도 나타나는지를 확인합니다.
분석 및 권장사항
주요 발견사항
남아 있는 자료로 가장 분명하게 확인되는 문제는 측정 지표의 잘못된 이름, D와 E 값의 혼동, 선언된 설정과 본문 설명의 불일치입니다. 성능 수치의 반복성이나 원인은 아직 검증되지 않았습니다.
워크로드별 권장 구성
| 필요한 동작 | 비교할 항목 |
|---|---|
| 일반 HTTP 서비스 | 목표 부하에서 오류율·p99, 연결 재사용, 서버와 부하 발생기 CPU |
| UDP 스트리밍 | 허용 손실률에서의 수신 처리량, pacing, 패킷 크기 |
| 서비스·endpoint가 많은 클러스터 | 규칙 갱신 시간, 새 연결률, 데이터 경로 모드 |
| 에이전트·모델 서비스 | 실제 도구 호출·스트리밍 경로, 정책 집행, 전체 응답 시간 |
| 세밀한 egress 제어 | DNS·FQDN·L7 정책의 지원 범위와 관측·운영 비용 |
서비스 500개나 5,000개 같은 보편적인 전환 기준은 이 자료에서 도출할 수 없습니다. 기존 운영 방식, 필요한 기능, 지원 책임과 측정 결과로 결정합니다.
구성 시 주의사항
eksctl 클러스터 생성
저장된 EKS 1.31 설정은 역사적 실험의 입력입니다. 새 클러스터에는 실험 시점에 지원되는 EKS·Cilium 조합을 별도로 선정해야 합니다. 기존 운영 클러스터를 실험 대상으로 전환하지 말고, 전용 환경의 생성·삭제 권한과 비용·정리 절차를 정합니다.
Cilium Helm 차트 호환성
Helm values의 이름·자료형·기본값은 릴리스마다 다를 수 있습니다. 선택한 차트 버전의 문서를 확인하고 렌더링한 리소스, 적용 후 values, Cilium 상태를 저장합니다. 설치 명령이 성공했다는 사실만으로 ENI·host routing·BBR·XDP가 모두 활성화되었다고 판단하지 않습니다.
XDP 가속 사용 조건
Native XDP 지원은 드라이버·커널·MTU·장치 설정에 달려 있습니다. “ENA나 가상화 환경은 모두 미지원” 또는 CPU 아키텍처만으로 지원 여부를 단정하는 표는 부정확합니다. Cilium 공식 문서는 AWS ENA 환경의 XDP 설정 사례를 제공합니다. 이 사례가 본 실험의 m6i.xlarge와 1.16.5 구성에서 성공했다는 의미는 아닙니다.
DSR (Direct Server Return) 호환성
DSR은 backend가 응답을 직접 클라이언트로 돌려주는 방식이고, XDP는 특정 수신 경로를 가속하는 방식입니다. DSR이 항상 XDP를 요구하는 것은 아닙니다. Cilium의 XDP 가속은 조건에 따라 DSR·SNAT·hybrid 모드에 적용될 수 있습니다. AWS 환경에서는 source/destination check, 캡슐화 방식과 네트워크 장비의 옵션 처리도 확인해야 합니다.
워크로드 배포
같은 노드와 다른 노드 실험을 명시적으로 분리하고, readiness뿐 아니라 응답 내용·오류율·실제 endpoint를 확인합니다. CPU 제한으로 인한 throttling이나 부하 발생기의 포화가 네트워크 차이로 보이지 않도록 함께 관측합니다.
CNI 전환 시 Pod 재시작
CNI 변경은 Pod의 네트워크 연결을 바꾸므로 단순한 애플리케이션 재시작처럼 취급하지 않습니다. Kubernetes Deployment의 기본 RollingUpdate 값은 maxSurge: 25%, maxUnavailable: 25%이며 반올림 규칙이 다릅니다. Pod가 항상 두 배가 된다는 설명은 맞지 않습니다. 작은 replica 수, 여유 용량과 종료 중인 Pod를 포함해 실제 최대 사용량을 계산해야 합니다.
모든 Pod를 일괄 삭제하는 방식은 안전한 전환 절차가 아닙니다. 전용 실험 클러스터에서 복구·재생성 방법을 검증하고, 서비스 환경의 전환은 별도의 지원 절차와 변경 계획으로 다룹니다.
AWS 인증
실험용 계정·역할·리전·클러스터 context를 먼저 확인하고 ENI 작업에 필요한 권한을 해당 역할에 부여합니다. 장기 키를 문서나 실행 결과에 넣지 않습니다. 이 보고서는 인증 또는 CNI 마이그레이션의 완성된 절차를 제공하지 않습니다.
참고: VPC CNI vs Cilium 네트워크 정책 비교
AWS VPC CNI 문서는 Kubernetes NetworkPolicy의 Pod·namespace selector와 CIDR 기반 제어를 설명합니다. 따라서 이를 IP 주소만 지정할 수 있는 정책으로 설명하면 부정확합니다. 아래 FQDN 예시는 Cilium의 확장 정책이며, 이 검토에서 VPC CNI의 FQDN 기능·API·지원 버전을 확인한 것은 아닙니다. 특정 제품만 지원한다고 단정하지 말고 비교할 API와 버전의 공식 근거를 확인합니다. 현재 기능을 2026년 2월 실험에 소급 적용하지 말고, 각 버전·노드 유형의 지원 범위를 기록해야 합니다.
주요 차이점
Kubernetes NetworkPolicy와 Cilium의 확장 정책은 API와 집행 방식이 다릅니다. Cilium의 HTTP L7 규칙은 프록시 경로와 TLS 가시성 조건을 고려해야 하며 암호화된 요청의 경로를 자동으로 검사한다고 가정하지 않습니다. Hubble 관측도 집계·필터·버퍼·손실 상태를 확인해야 하므로 모든 흐름이 무조건 보존된다고 표현하지 않습니다.
FQDN egress는 도메인 규칙뿐 아니라 DNS 조회 허용이 필요합니다. 다음은 bench의 app: api-client Pod가 CoreDNS를 조회하고 api.example.com의 TCP 443에 접근하도록 표현한 Cilium 정책 예시입니다. 클러스터의 DNS Pod label과 resolver 경로가 이 예시와 맞는지 확인해야 하며 실행 검증은 하지 않았습니다.
apiVersion: cilium.io/v2
kind: CiliumNetworkPolicy
metadata:
  name: api-client-egress
  namespace: bench
spec:
  endpointSelector:
    matchLabels:
      app: api-client
  egress:
    - toEndpoints:
        - matchLabels:
            k8s:io.kubernetes.pod.namespace: kube-system
            k8s:k8s-app: kube-dns
      toPorts:
        - ports:
            - port: "53"
              protocol: ANY
          rules:
            dns:
              - matchPattern: "*"
    - toFQDNs:
        - matchName: api.example.com
      toPorts:
        - ports:
            - port: "443"
              protocol: TCP
DNS 조회의 *는 모든 목적지로의 TCP 연결 허용을 뜻하지 않습니다. 반대로 *.amazonaws.com 같은 넓은 egress 패턴은 특정 AWS 서비스 하나만 허용하는 규칙이 아닙니다. 실제 서비스·리전의 endpoint와 필요한 포트를 지정하고 허용·거부 사례를 함께 검증합니다.
참고 자료
- 저장된 스크립트·요약 결과
- Amazon EC2 M6i 사양
- Cilium kube-proxy replacement, DSR와 XDP
- Cilium Bandwidth Manager와 BBR
- Cilium DNS·FQDN 정책
- Amazon VPC CNI NetworkPolicy
- Kubernetes Deployment RollingUpdate
- iperf3 사용 설명서
위 공식 문서는 2026-09-19 검토 시점의 설명입니다. 과거 실행의 지원 조건은 해당 릴리스 자료와 당시 설정으로 별도 확인해야 합니다.